De AI-industriële revolutie in de maak
Vijf industriële revoluties, en de tijd ertussen wordt steeds korter. Ik neem je mee van Boulton en Watt naar de GPU-clusters van vandaag, laat zien wat de testen zeggen, en waarom de meeste metaalbedrijven vastlopen: AI in een app, zonder de context van het bedrijf. Eerst context, dan agents.

Korte samenvatting: We zitten midden in de AI-industriele revolutie: een nieuwe doorontwikkeling van de 4e industriële revolutie. Het beste te beschrijven als een renaissance in de wereld van software en code. Deze verschuiving maakt ieder maakbedrijf een software bedrijf en geef ongekened productiviteitsmogelijkheden.
Op LinkedIn roept iedereen AI. Je ERP-leverancier heeft het ineens ook. En in bijna elk metaalbedrijf waar ik kom, hoor ik hetzelfde: we hebben ChatGPT geprobeerd. Een paar keer mee gechat. Weer verder gegaan.
Sommigen zijn een stap verder en werken met Claude. Een enkeling heeft misschien een eerste appje gebouwd, zoals Lovable. Maar de meesten zitten nog in playtime: uitproberen, zonder dat er in het bedrijf iets verandert.
Dat klinkt logisch. Het ding maakt fouten, het kent je bedrijf niet, en je hebt het druk genoeg.
Maar daarmee loop je een factor tien achter op technologie die er al is. Niet straks. Nu.
Daarom deed ik in Metaal Connect LIVE #16 iets anders dan anders. Geen demo, geen verkooppraatje. Ik nam je mee terug in de tijd. Want als je snapt hoe de vorige vier revoluties gingen, snap je ook waarom deze zo anders voelt. En waarom hij zo snel gaat.
Pak een kop koffie. Dit wordt een reis van ruim tweehonderd jaar, en we eindigen bij jouw werkvloer.
Eerst terug in de tijd
Elke industriële revolutie draait om hetzelfde. Meer doen met minder mensen. Meer output per uur. Alleen het gereedschap verandert, en elke keer staat er iemand op die het als eerste durft te gebruiken.
Laten we bij die mensen beginnen.
1. Mechanisatie: Boulton verkoopt kracht
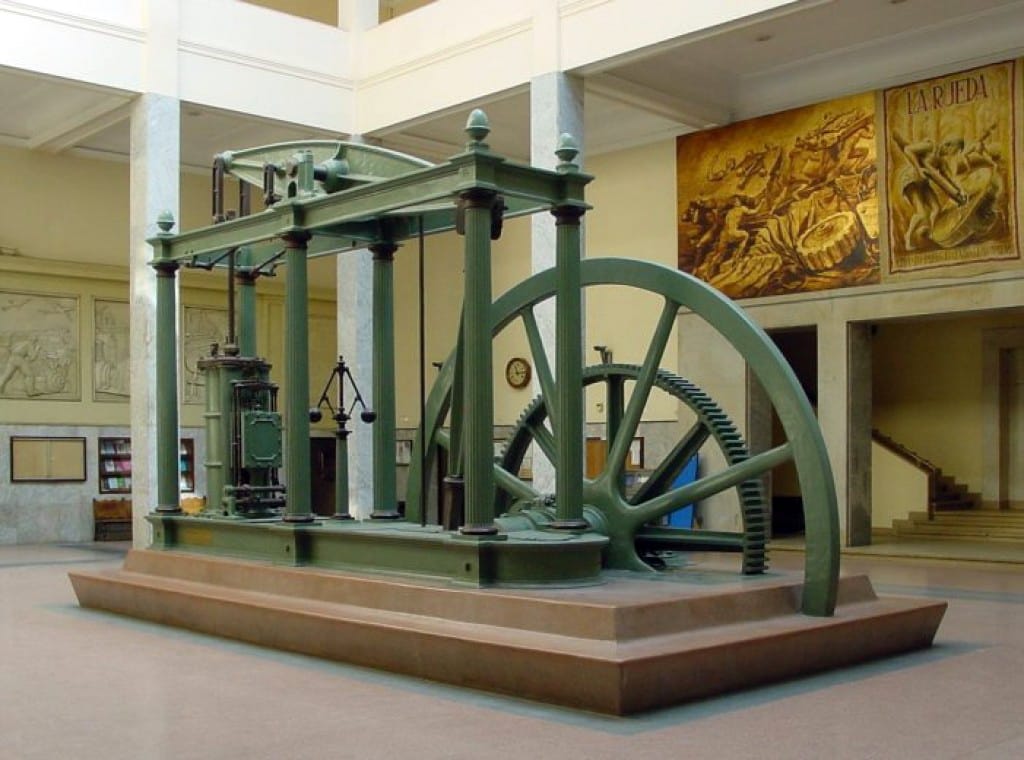
Birmingham, 1776. Een Schotse instrumentmaker, James Watt, heeft jaren gesleuteld aan een stoommachine die eindelijk zuinig genoeg is om geld op te leveren. Zijn zakenpartner Matthew Boulton leidt een bezoeker rond door de fabriek en zegt de zin die ik niet meer kwijtraak:
Tot dat moment kon een mens niet meer maken dan wat hij fysiek aankon. Hooguit met een paard erbij. Daarom moest Watt zijn klanten, molenaars en brouwers, uitleggen in de enige eenheid die ze kenden: hoeveel paarden vervangt dit ding? Zo is de paardenkracht ontstaan. Een marketingtruc van een ingenieur.
Daarna ging het hard. Spinnerijen op stoom. In 1829 won Stephensons Rocket de wedstrijd om de eerste echte spoorlijn, met bijna vijftig kilometer per uur. Binnen één generatie stonden de eerste echte fabrieken er.
2. Massaproductie: Ford kijkt in een slachthuis
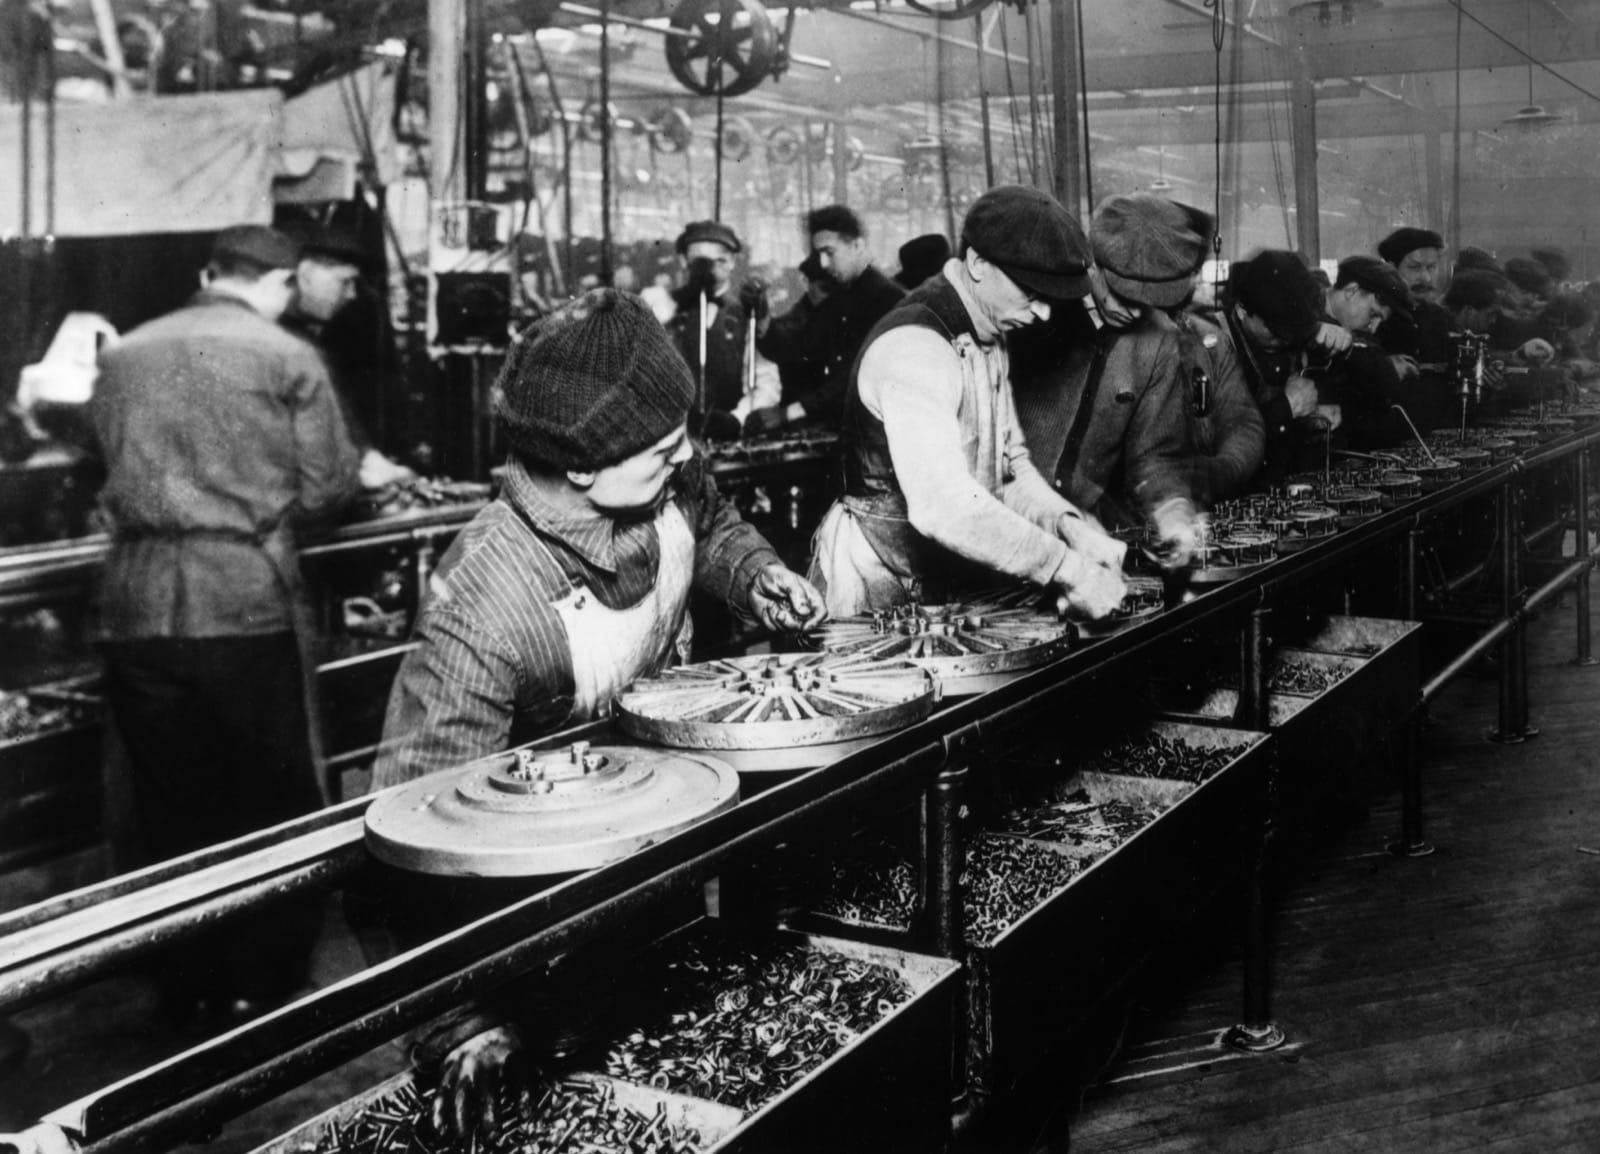
Honderd jaar later. Henry Ford loopt rond in Highland Park, bij Detroit, en heeft een probleem. Zijn Model T is populair, maar het bouwen gaat te langzaam. Een auto in elkaar zetten kost ruim twaalf uur.
Zijn mensen hadden in de slachthuizen van Chicago iets gezien. Daar hing het vlees aan een rail en bleven de slagers staan. Elke man één handeling. Ford draaide dat om: laat de auto bewegen, niet de monteur.
Op 7 oktober 1913 startte de eerste lopende band. Binnen een jaar zat de bouwtijd op anderhalf uur. Dezelfde mensen, dezelfde auto, een factor acht meer output. De prijs van een Model T zakte van ruim 800 dollar naar onder de 300. En Ford verdubbelde het loon van zijn mensen, naar vijf dollar per dag, zodat ze de auto zelf konden kopen.
Dat is wat een revolutie doet. Het werk zelf verandert nauwelijks. De manier waarop het georganiseerd is wel. En daar zit de winst.
3. Automatisering: een robot schenkt koffie
Weer een paar generaties verder. In 1947 bouwen Bardeen, Brattain en Shockley bij Bell Labs de eerste transistor. Een stukje halfgeleider dat een schakelaar vervangt. Niemand op de werkvloer merkt er iets van. Nog niet.
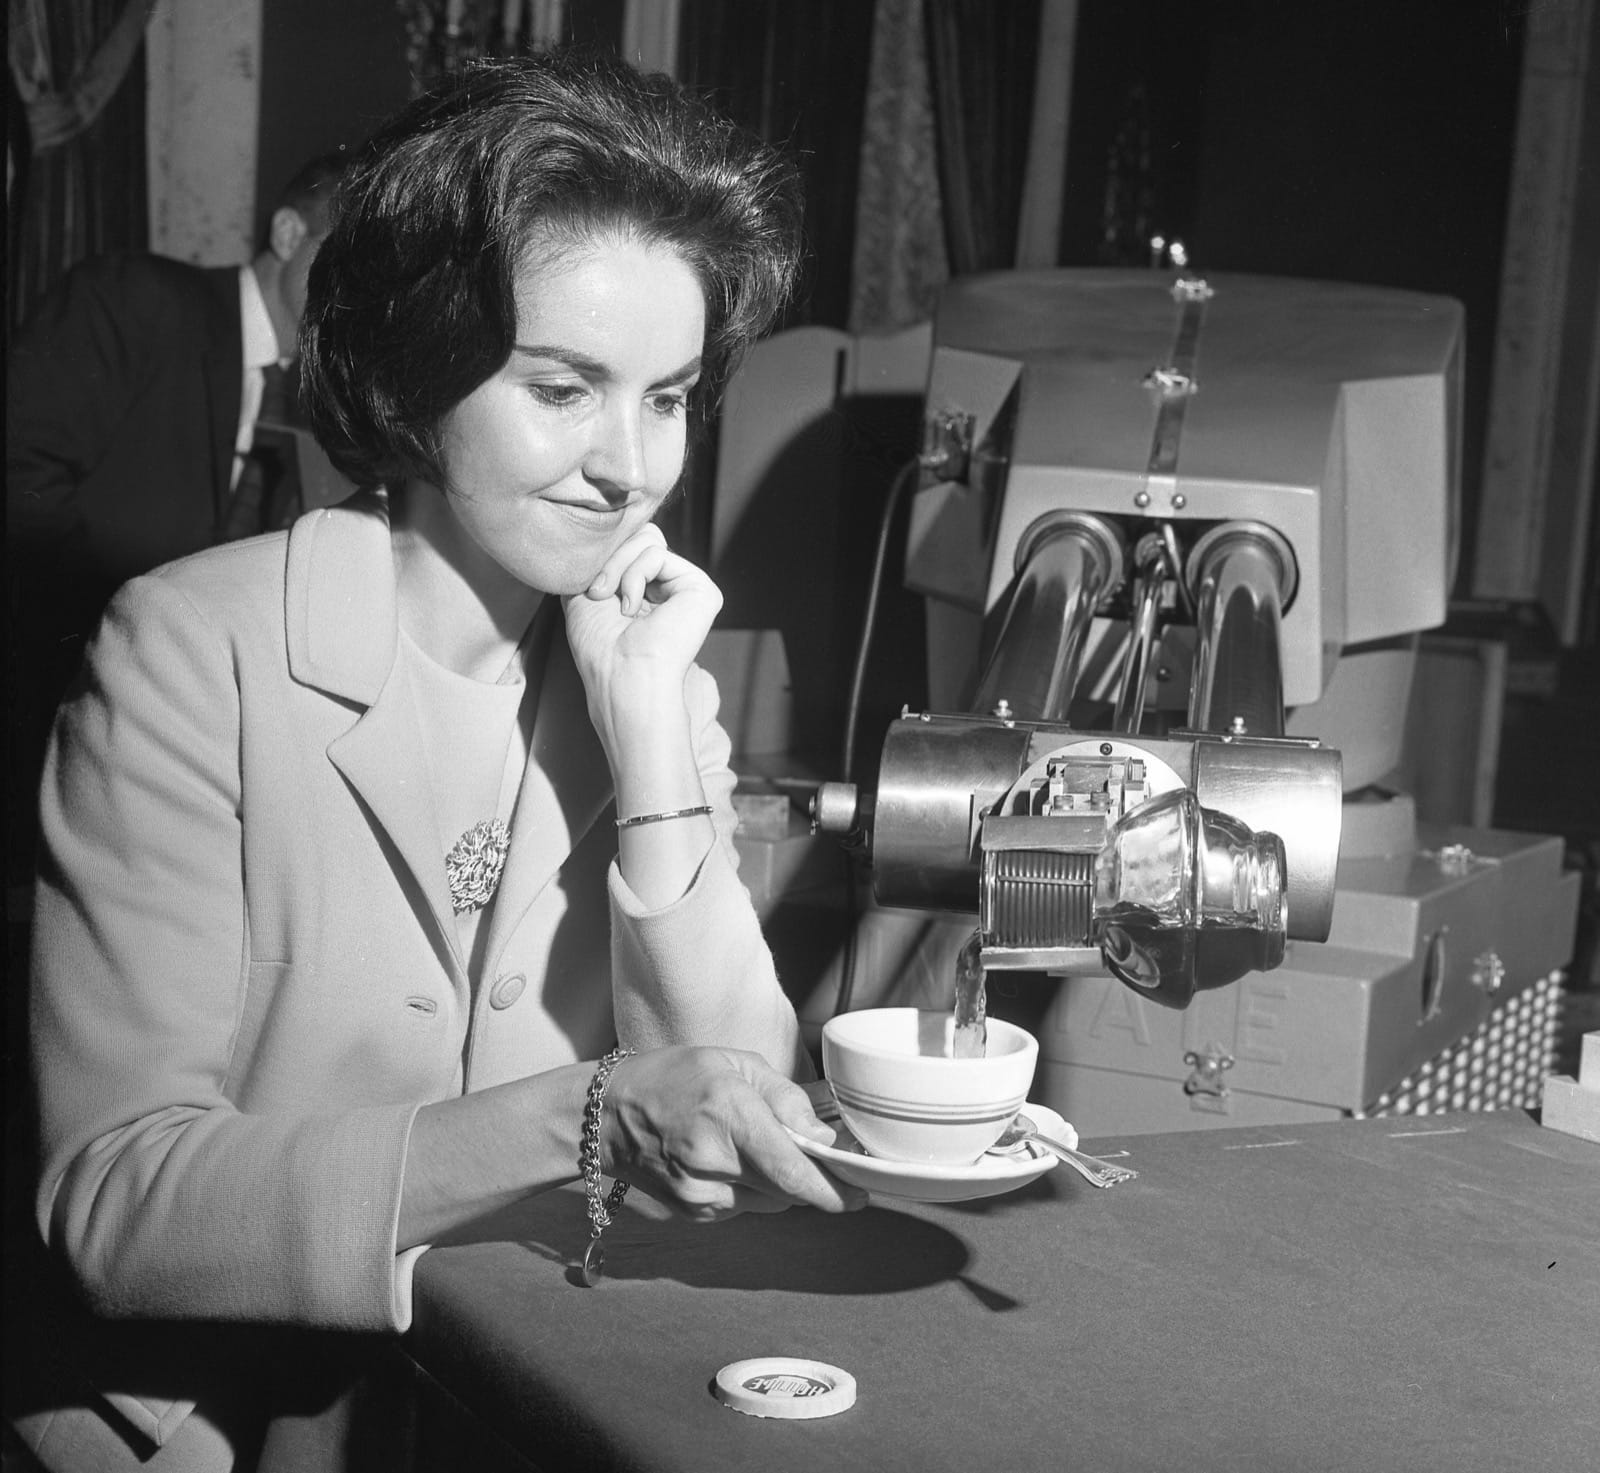
In 1961 staat bij General Motors in New Jersey de eerste industriële robot: de Unimate van George Devol en Joseph Engelberger. Hij tilt gloeiende gietstukken uit een matrijs. Werk waar niemand zin in had. Zes jaar later schenkt hij voor de camera koffie in.
En dan 1968. Dick Morley, een ingenieur uit Massachusetts, schrijft op nieuwjaarsdag een memo. Bij General Motors staan kasten vol relais, en bij elke modelwissel moet alles met de hand omgebouwd worden. Weken werk. Zijn idee: een computer die je programmeert in plaats van een kast die je ombouwt. De eerste PLC. De Modicon 084 ging in 1969 de fabriek in.
Klinkt bekend? Een kast ombouwen, of een regel software aanpassen. Dat is precies de belofte die we nu weer horen, alleen een laag hoger.
4. Open connectiviteit: een sticker op een computer
Nu wordt het persoonlijk, want hier begon mijn eigen vak en eerste werkzaamheden als integrator.
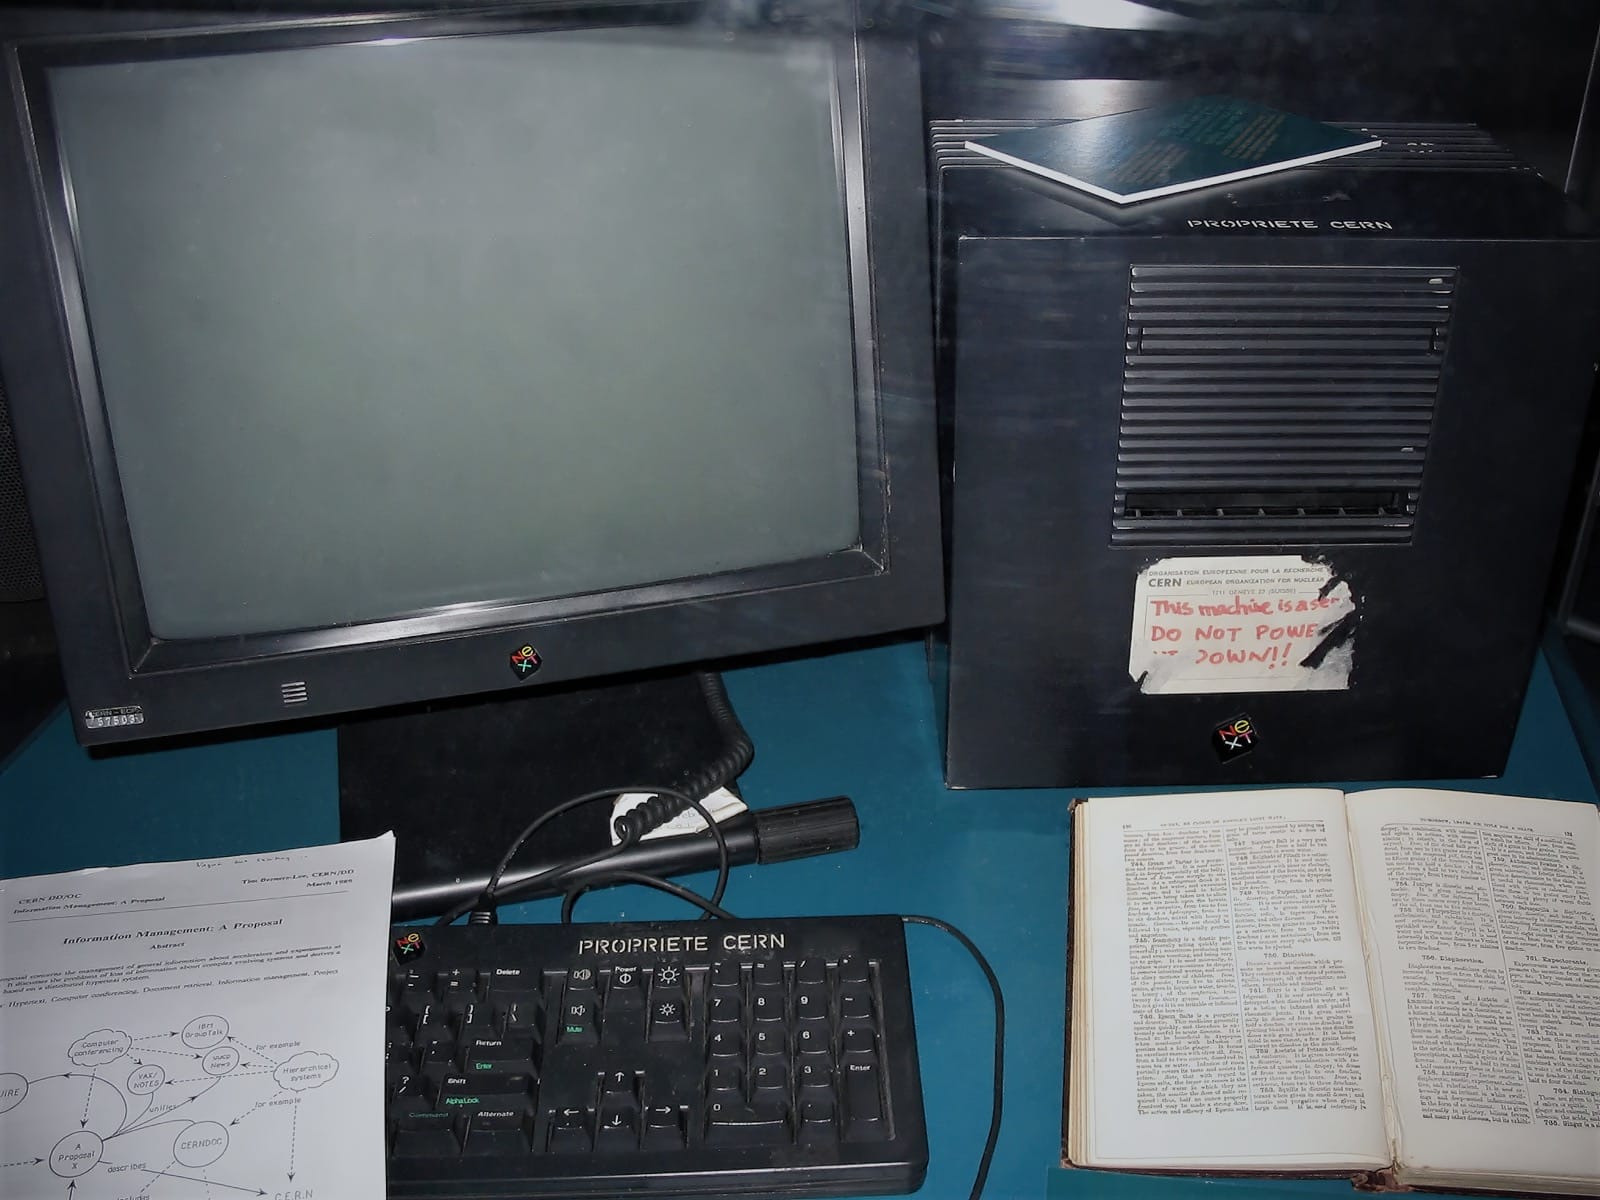
In 1973 schrijft Bob Metcalfe bij Xerox een memo over een netwerk dat hij Ethernet noemt. In 1974 bedenken Vint Cerf en Bob Kahn het protocol dat we nog steeds gebruiken: TCP/IP. En in 1989 schrijft een jonge Brit bij CERN een voorstel voor iets wat hij het World Wide Web noemt. Zijn baas zet er met pen op: vague but exciting.
Die Brit heette Tim Berners-Lee. Zijn eerste webserver was een zwarte NeXT-computer met een sticker erop: This machine is a server. Do not power down!
Rond 2000 bereikte dat alles de fabriek. Machines kregen een netwerkaansluiting. Ze konden met het netwerk praten, en via dat netwerk met het internet. Later kwamen er standaarden als OPC UA bij, zodat machines van verschillende merken elkaar verstonden.
Let op de volgorde. TCP/IP bestond al sinds de jaren zeventig, het web sinds 1990. Toch duurde het tot rond 2012 voordat Duitsland, met zijn hele machinebouw, op de Hannover Messe de alarmklok sloeg en er een naam aan gaf: Industrie 4.0, letterlijk de vierde industriële revolutie. De techniek was niet nieuw. Ze zagen wat er elders in de wereld al gebeurde, en hoe traag de eigen fabrieken bewogen.
Dat is de les van deze revolutie: een technologie kan tientallen jaren bestaan voordat hij de werkvloer raakt. Een nieuwe machine koop je eens in de vijftien jaar. Een netwerkkabel trek je pas als er een reden is.
En nu komt het. De meeste metaalbedrijven die ik spreek zitten hier nog middenin. Sommige zijn er nog niet aan begonnen. Onthoud dat even, want het komt terug.
5. Intelligentie op schaal: van gamekaart tot ChatGPT
Terug naar 2012, hetzelfde jaar waarin Duitsland de alarmklok luidde. In Toronto laten Geoffrey Hinton en twee van zijn studenten, Alex Krizhevsky en Ilya Sutskever, een neuraal netwerk los op een wedstrijd in beeldherkenning. Ze trainen het op twee grafische kaarten die eigenlijk voor games bedoeld zijn. Het verslaat alles wat ervoor kwam, met afstand.
Vanaf dat moment weet de onderzoekswereld twee dingen. Dit werkt. En het schaalt met rekenkracht.
Vijf jaar later, in 2017, publiceren acht onderzoekers van Google een paper met een titel die klinkt als een popsong: Attention Is All You Need. Erin staat de transformer, de architectuur waar elk taalmodel van vandaag op draait. Bijna niemand buiten het vak leest het.
OpenAI leest het wel. Ze maken de modellen steeds groter: GPT-2, GPT-3. Indrukwekkend, maar alleen bruikbaar voor wie kon programmeren. Tot 30 november 2022. Dan zetten ze er een chatvenster voor en noemen het bescheiden een research preview. Twee maanden later gebruiken honderd miljoen mensen ChatGPT. Geen enkele toepassing was ooit zo snel zo groot.
En let op het verschil met Watt, Ford en Morley. De fabriek bestaat nog steeds, maar hij staat niet meer bij jou. Hij staat bij OpenAI, Google en Anthropic: hallen vol GPU-clusters die een nieuwe grondstof maken, intelligentie. Precies zoals de elektriciteitscentrale rond 1900 kracht maakte en jij alleen nog een stopcontact nodig had.
Jij hoeft dus geen fabriek te bouwen. Geen machine, geen kabel, geen installateur. Een browser was genoeg. Daarom gaat deze revolutie zo veel sneller dan de vorige: de zware kant staat ergens anders, en de aansluiting zit in je broekzak.
En dat maakt intelligentie voor jou als gebruiker een grondstof, net als stroom, gas of staal. Je koopt het per eenheid, je sluit het aan op je proces, en je verbruikt zoveel als je nodig hebt. Alleen is deze grondstof elke paar maanden beter en goedkoper dan de vorige levering.
Dat Sutskever later OpenAI mee oprichtte, en dat diezelfde gamekaarten nu bij mij op kantoor de open modellen draaien? Geen toeval. Een klein stukje van die fabriek kun je dus ook gewoon zelf neerzetten. Dit is één verhaal, en jij zit er middenin.
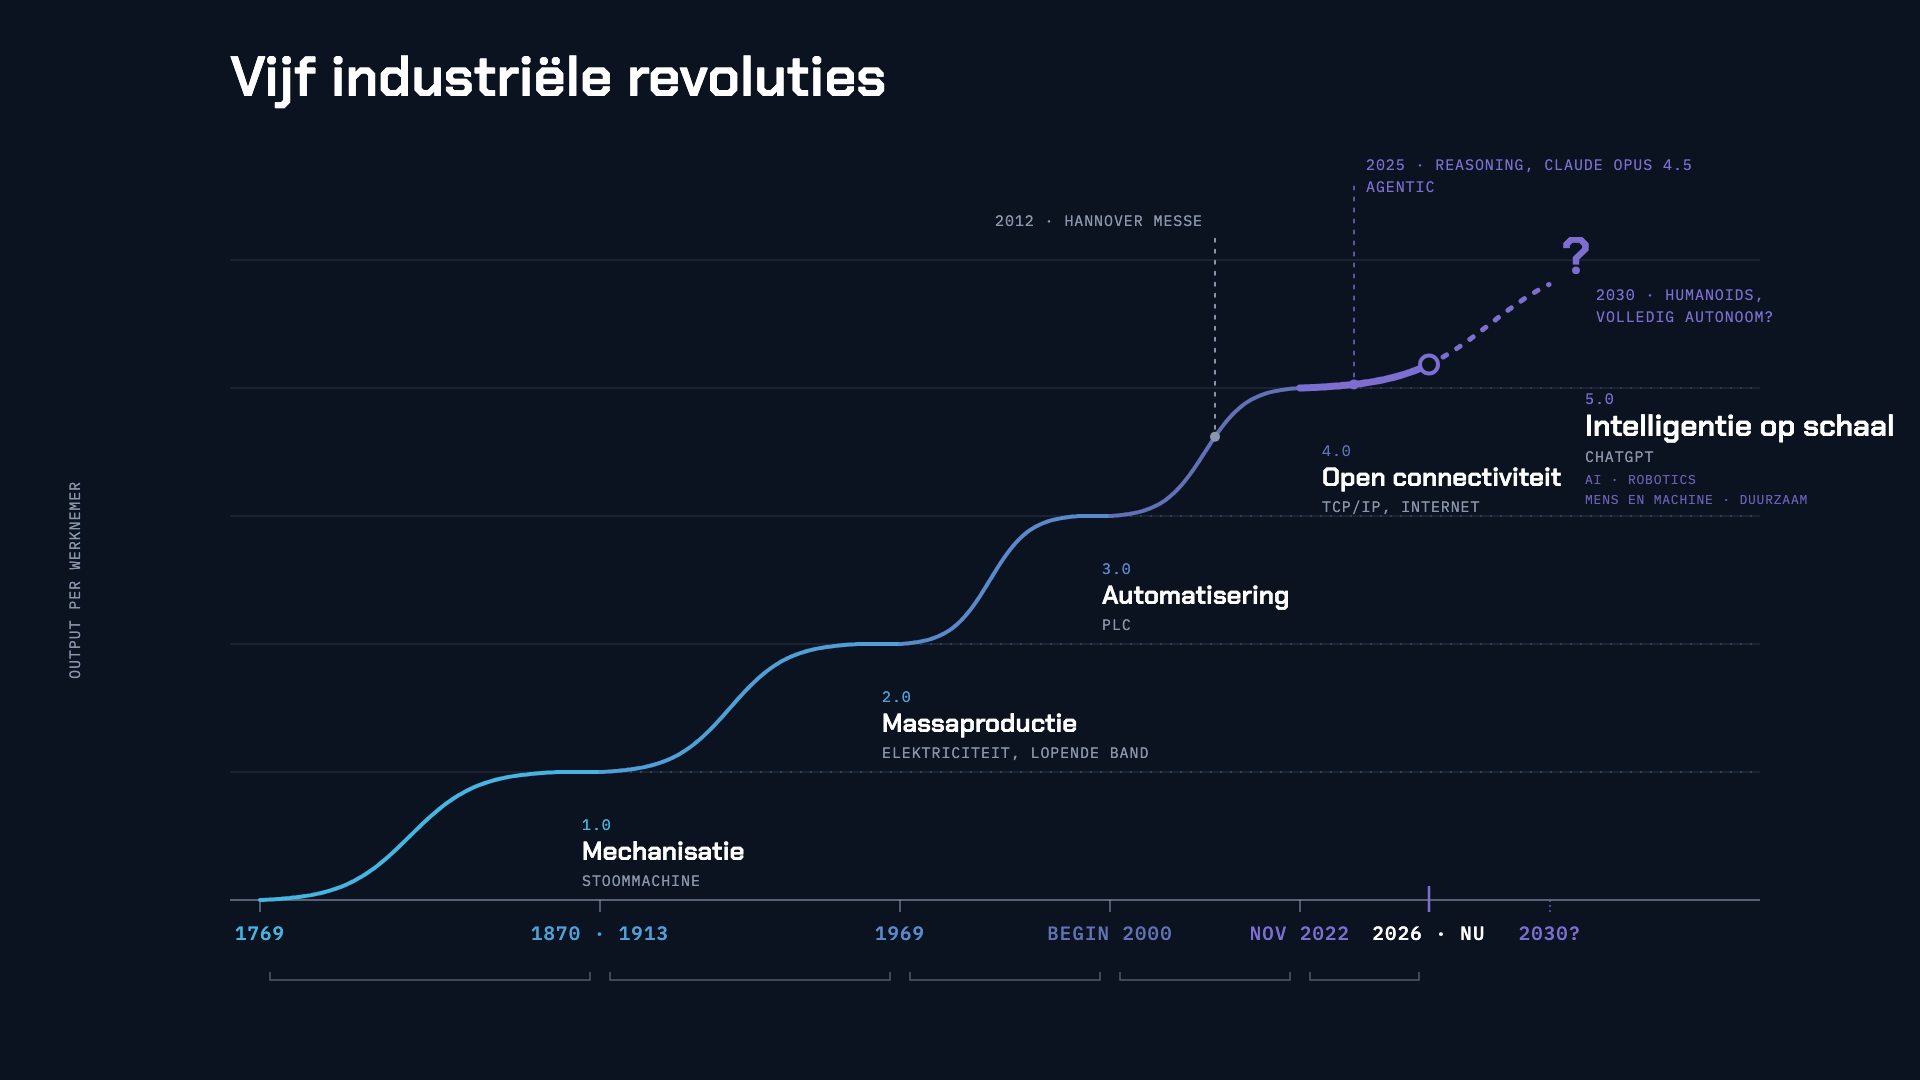
Zet de jaartallen eens naast elkaar
Van Boulton naar Ford: ongeveer honderd jaar. Van Ford naar Morley: zo'n tachtig. Van de eerste PLC naar de machine aan het internet: dertig, en eigenlijk minder dan twintig.
En van november 2022 tot vandaag? Nog geen vier jaar.
Hoe lang deze duurt, weet niemand. Maar stel dat het nog eens vier jaar duurt, tot 2030. Dan heeft deze revolutie acht jaar geduurd. Opnieuw de helft. Dat is geen voorspelling, het is het patroon doorgetrokken. En dat patroon heeft een naam: exponentiële groei. Alles verdubbelt.
Daarom durf ik het label erop te plakken: we zitten in de AI-industriële revolutie.
Bij elke vorige revolutie was er één uitvinding. Die uitvinding had jaren nodig voordat de industrie hem had uitgerold. Daarna verschoof de economie. Er stonden nieuwe partijen op, en er gingen er veel weg. ChatGPT is die uitvinding. Niet de revolutie zelf, maar de katalysator, zoals TCP/IP dat was voor Industrie 4.0. De revolutie is intelligentie op schaal, en die is nog lang niet klaar. De kinderziektes zijn er nog niet uit. We zitten nog aan het begin.
Jeff Bezos zei het in 2003 al, vlak na de dotcomcrash, in een TED-talk die ik iedereen aanraad. Hij vergeleek het web met elektriciteit rond 1900. De eerste elektrische apparaten schroefde je in de fitting van een lamp, want stopcontacten bestonden nog niet. Onhandig, soms gevaarlijk, en toch niet te stoppen.
Zo voelt AI nu. We schroeven het nog in de lampfitting van ons ERP. Kijk deze twintig minuten, en lees daarna verder.
Jeff Bezos, TED 2003: het web als elektriciteit rond 1900.
Oké, maar hoe goed is het nu echt?
Eerlijke vraag. Ik wil geen hype verkopen, dus laat ik gewoon de testen zien.
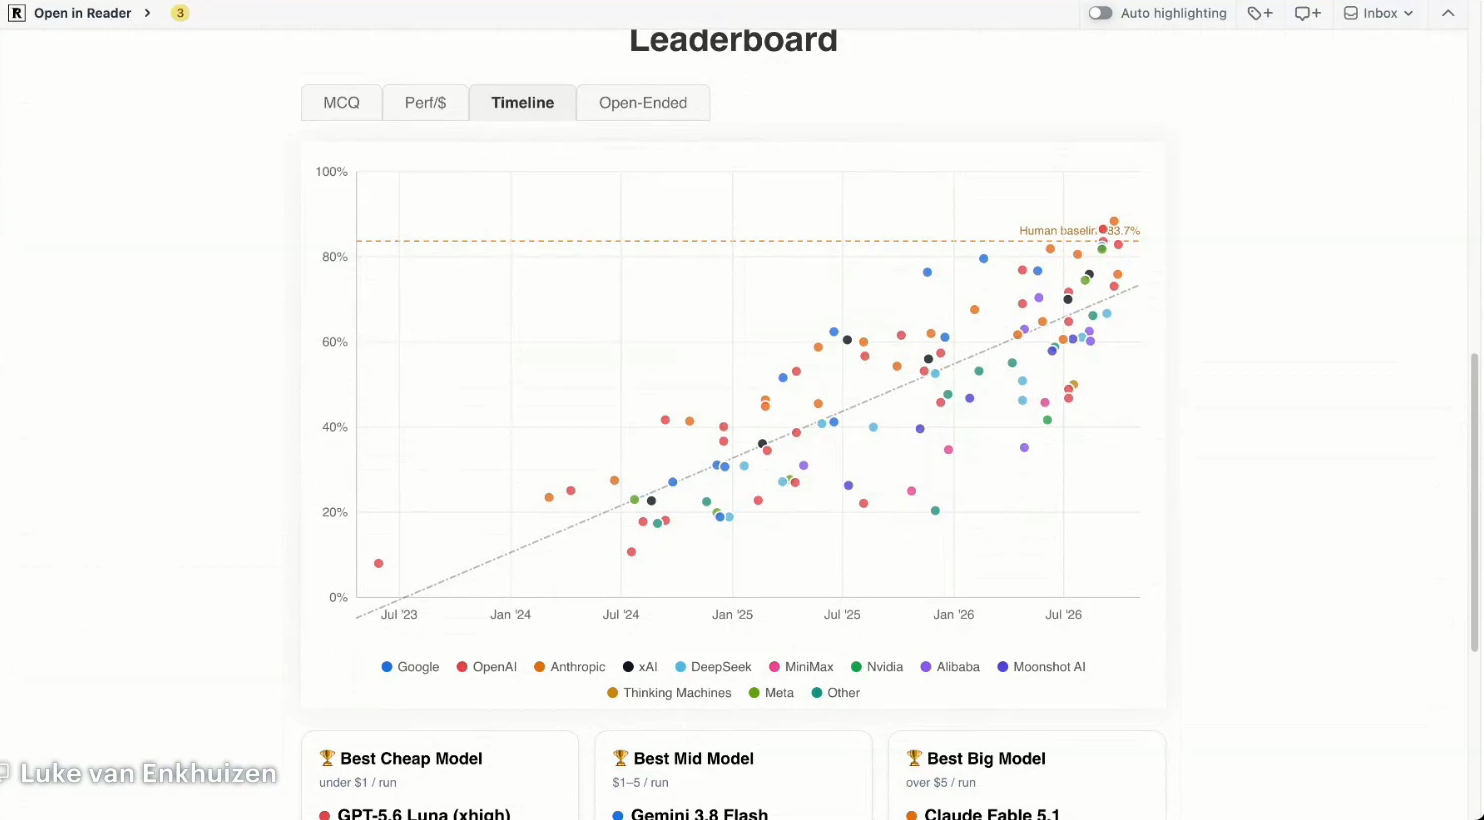
Een benchmark is een gestandaardiseerde test, net als een schooltoets. Hij laat zien wat een taalmodel presteert vergeleken met mensen, of met andere modellen.
Neem Simple Bench, van AI Explained. Een multiple-choicetest op middelbareschoolniveau, vol strikvragen. Mensen scoren gemiddeld zo'n 83%.
Juli 2023: het beste model, GPT-3.5, scoort 8%. Mensen lachten erom. Daarna de eerste modellen van Google en Claude. Nog steeds niet over de 30%.
En toen kwam deze zomer. De meeste nieuwe taalmodellen zitten nu boven de menselijke basislijn. De beste score staat op Claude Opus 5.5. De slimste mensen zijn nog niet verslagen. Maar je ziet waar het heen gaat, en hoe snel.
Dan het geld, want AI is niet goedkoop. OpenAI en Anthropic kunnen hun prijzen verhogen en de echte kosten in de abonnementen doorrekenen. Onderschat alleen de open modellen niet.
Kimi (K3) en Qwen zijn Chinese modellen die je gewoon kunt downloaden. Ze draaien al competitief mee. Bij mij op kantoor staan ze als een verkleinde versie op een gaming-pc en op een Mac. Maar onthoud: wat je vandaag lokaal installeert, is beter dan wat Claude begin dit jaar uitbracht.
Claude Opus 4.5 was voor mij het niveau waarvan ik dacht: hiermee kunnen we wat. Dat niveau draai je nu lokaal. Zonder internet, op hardware die van jou blijft. Net als een machine.
En deze modellen zijn zo slecht als ze ooit zullen zijn.
De derde test gaat over software. METR, een onderzoeksinstituut, meet hoe lang een model aan één taak kan werken voordat het de draad kwijtraakt.
In 2022 haalde GPT-3.5 een taak van ongeveer negen seconden mensenwerk, met 16% succes. Het zat vol fouten. Daar hebben de meeste mensen hun eerste indruk aan overgehouden.
Vandaag doen de modellen programmeertaken waar een mens minimaal zestien uur over doet, in de helft van de tijd of sneller. Met de lat op 80% betrouwbaarheid zitten we nu op de grens. De verwachting is dat de volgende modellen daar overheen gaan.
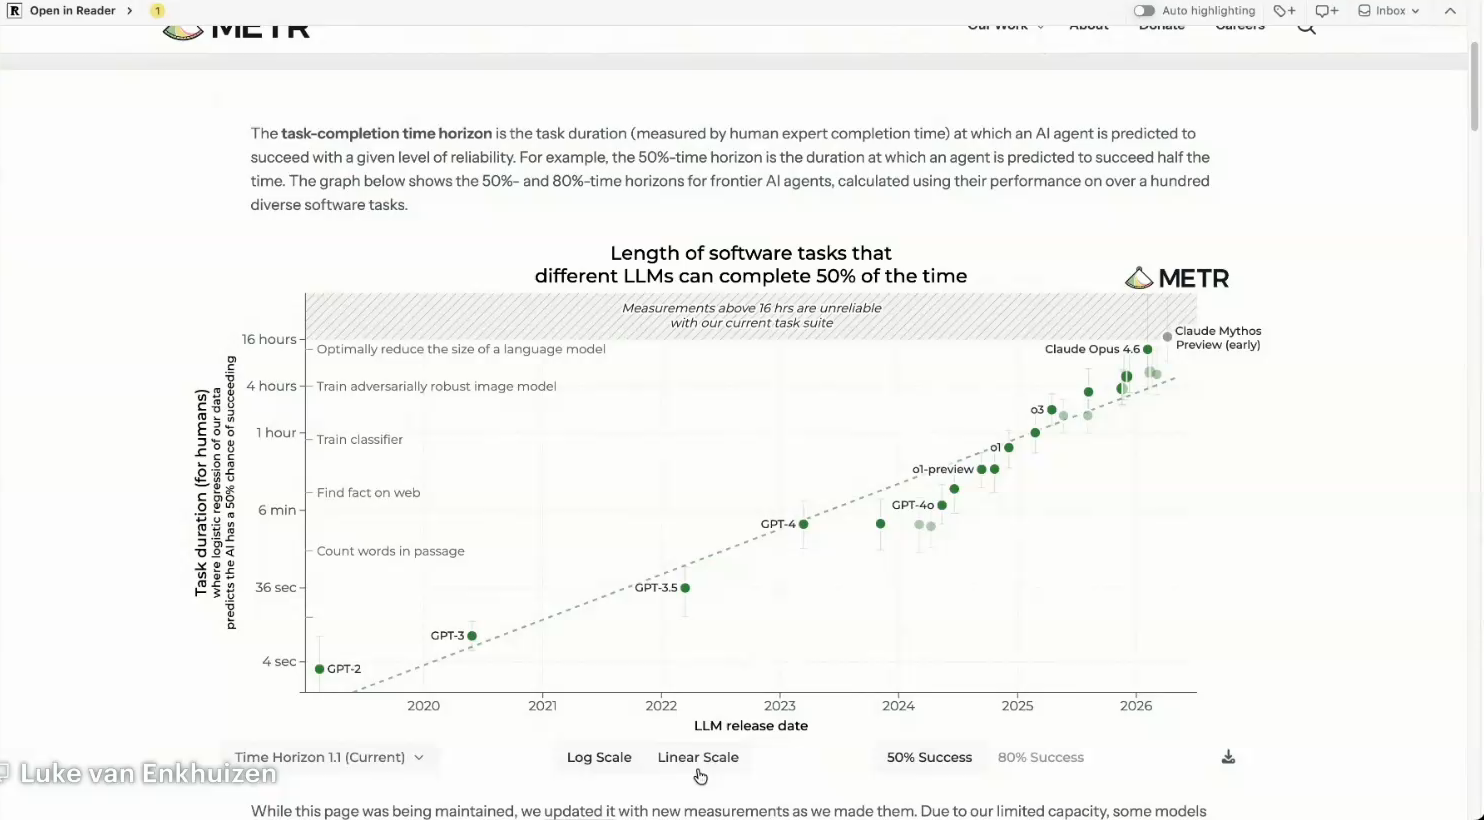
Die lijn loopt exponentieel. Hij verdubbelt steeds. Software maken, fabriekssoftware, zelfs besturingen: de curve komt daar nu aan.
Wat dit met je tekenkamer doet
Dit deel raakt mij, want hier kom ik vandaan.
Er zijn ook benchmarks voor tekenen. BenchCAD meet hoe goed een model tekeningen leest en maakt, tegen een referentiemodel.
Geef het een oude DXF of een ingescande pdf van een werktekening. Koppel het model aan een tekenpakket. Het tekent het 3D-model uit met vrij hoge precisie. In sommige gevallen sneller dan wij. Soms nauwkeuriger.
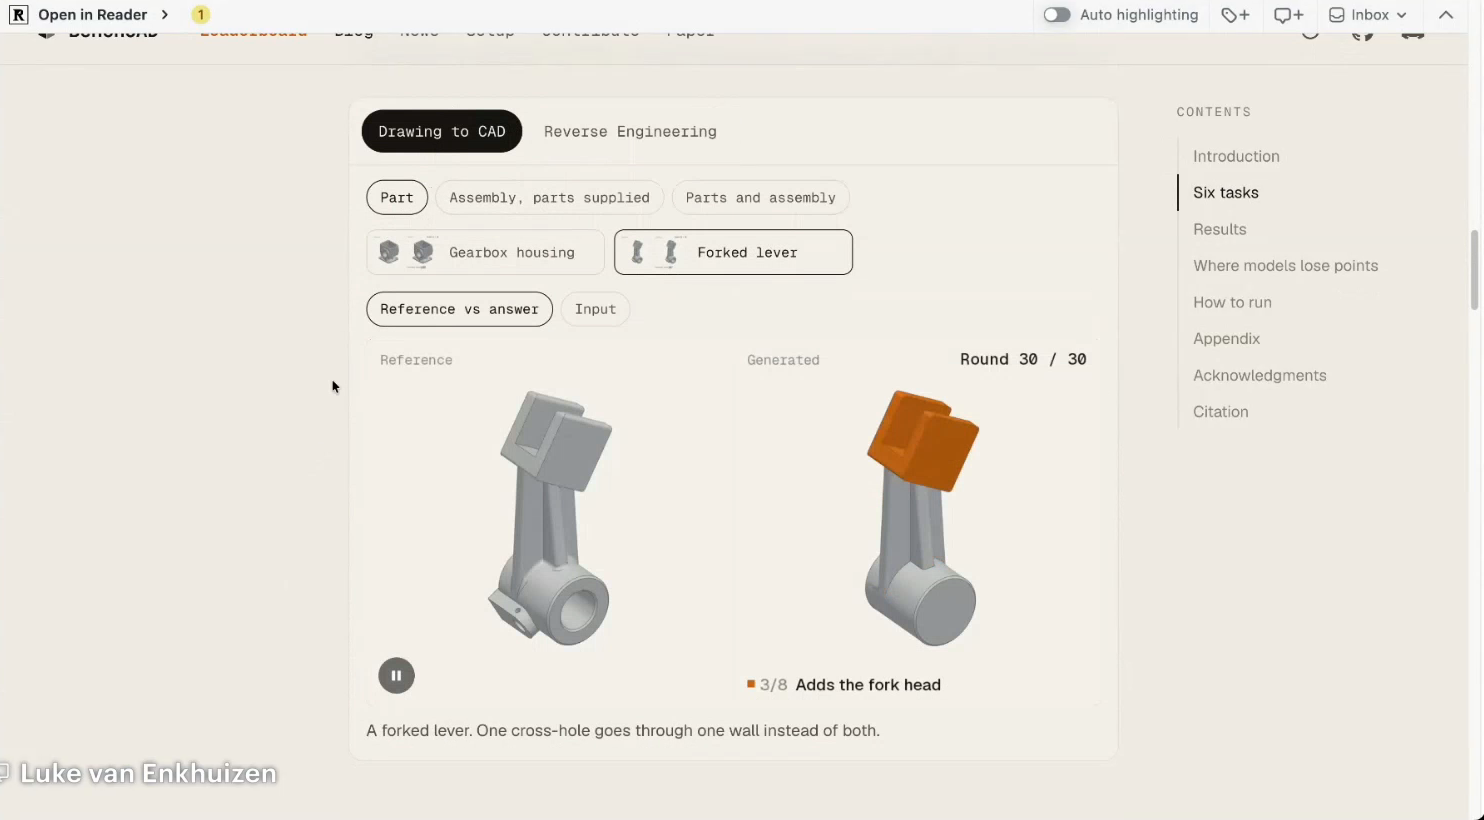
Je kunt de test zelf draaien. Download de code, sleep je eigen bestanden erin en kijk hoe goed je AI is. Clear Handoff, van een goede vriend van me, bouwt hierop.
Zo kom ik bij het getal uit de uitzending. Geef het beste model een pdf van een werktekening. Vraag het om de 3D-modellen te maken, alles uit te tekenen en te controleren.
Na ongeveer 31 minuten is het klaar. Kosten: zo'n 7 dollar. Laat het me weten als jij iemand vindt die dat verslaat. Elke dag, 24/7, met tien tegelijk als het moet.
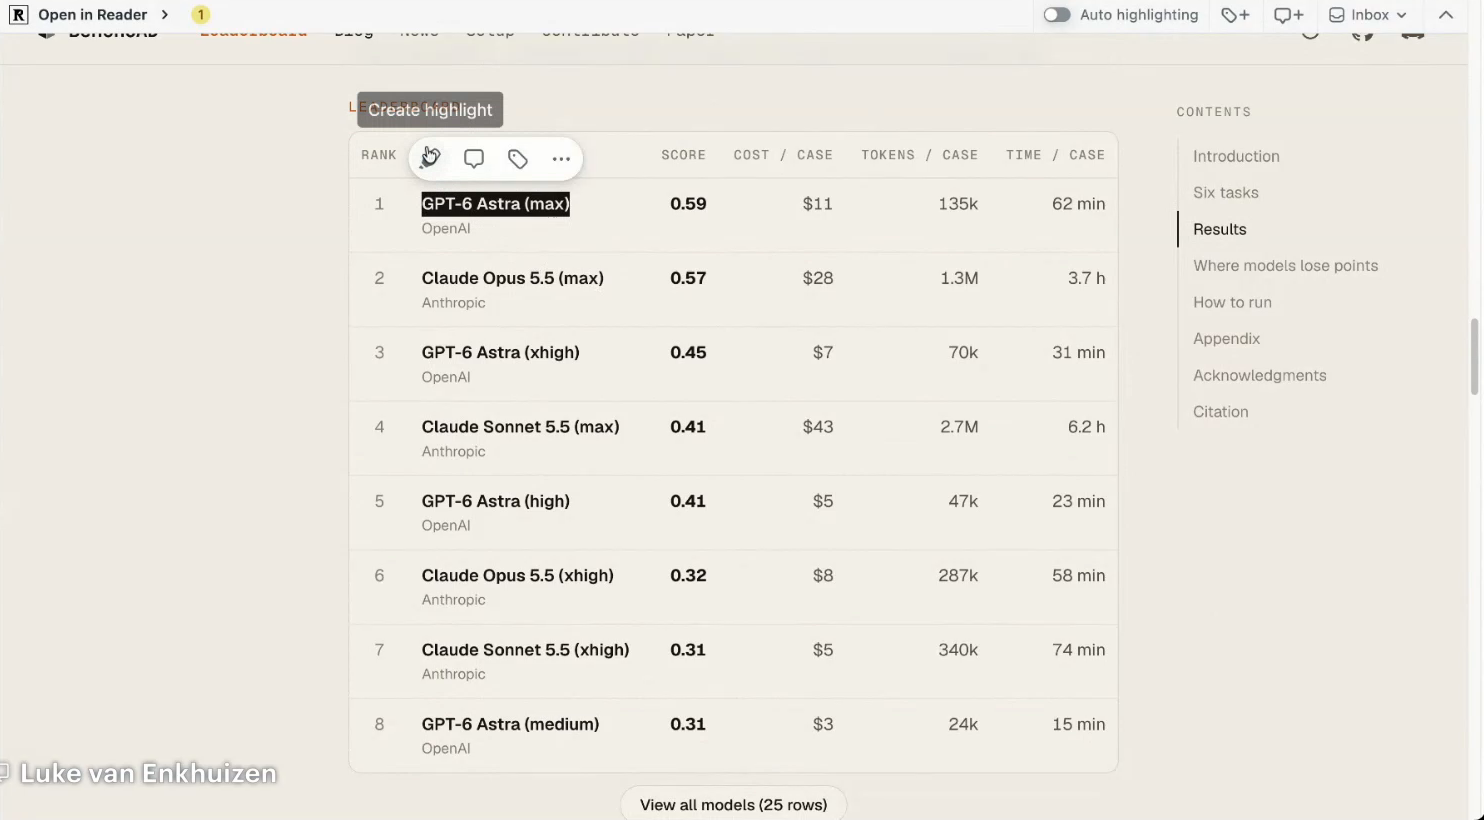
Hetzelfde geldt voor reverse engineering. Je krijgt een STEP-bestand van een klant en moet er iets in aanpassen. Als engineer hoorde dat bij mijn werk, en het was soms best lastig. AI zet zo'n STEP-bestand nu om naar een native bestand voor je tekenpakket.
Het gaat verder. Geen enkel softwarepakket op jouw systeem is veilig voor reverse engineering. Pakketten worden met AI bestudeerd en in andere talen herschreven. SolidCraft, een kruising van SolidWorks en Inventor, is daar een voorbeeld van. Pakketten waar je duizenden euro's voor betaalt, worden in rap tempo vervangen door AI-gegenereerde versies. En die versies zijn ook weer vanuit AI te bedienen.
Eén kanttekening. Tegen je licentieovereenkomst in reverse engineeren mag niet, tenzij je een bug omzeilt. Een jurist ben ik niet, dus check het.
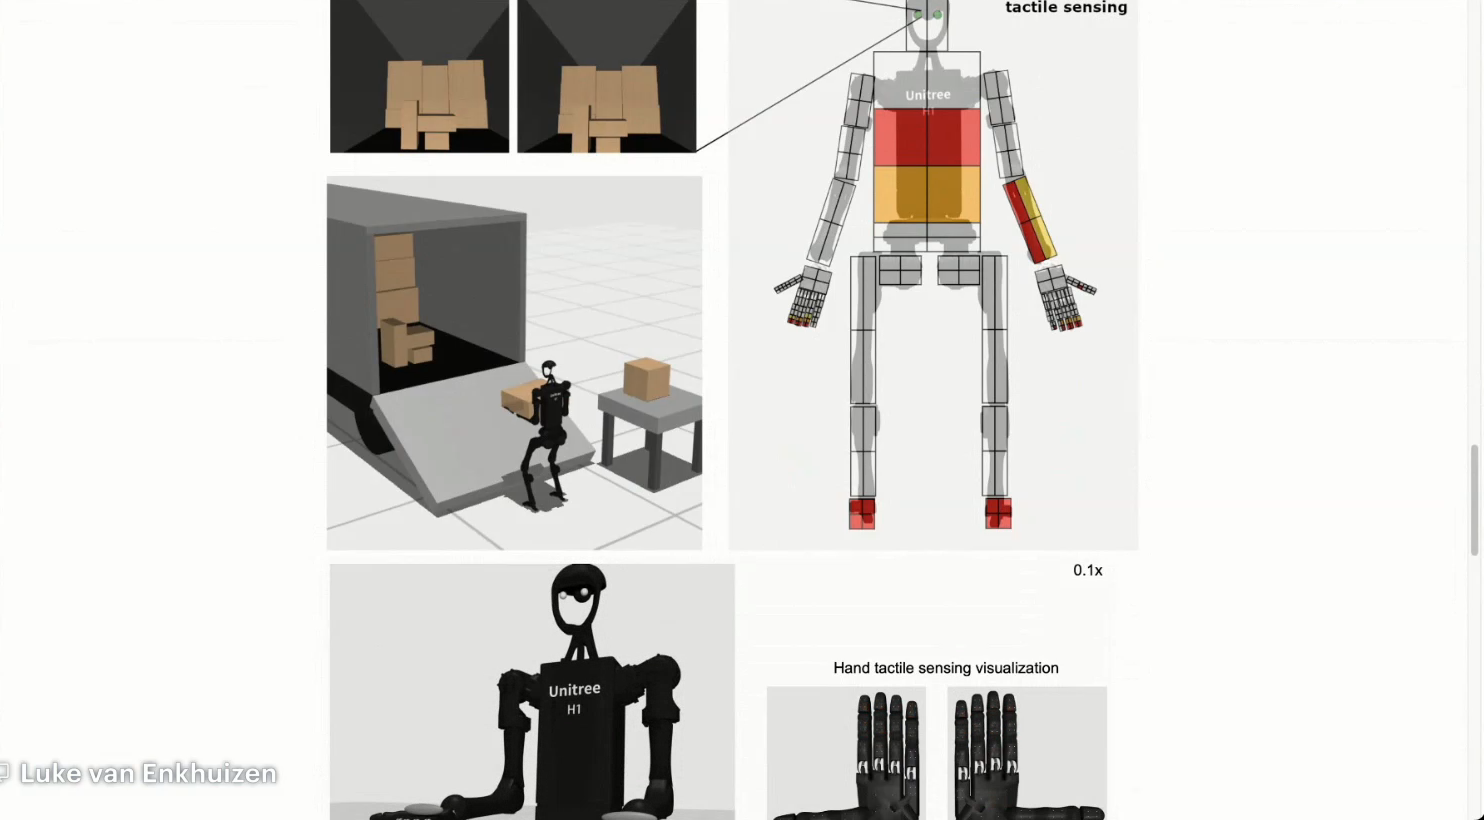
En de robots? Op de Hannover Messe zag je ze overal. Mechanisch zijn ze ver. Softwarematig nog niet.
Wat je nu ziet: robots zoals die van Unitree worden hardware waar je je eigen software op zet. AI programmeert die besturing en leert ervan. Ook daar komen benchmarks. Een mens laadt dozen in een vrachtwagen, een robot doet hetzelfde.
Nemen robots de wereld over? Nee, verre van. Maar denk nog even aan die Unimate met zijn koffiekan. Het gaat hard.
Waar het heen gaat
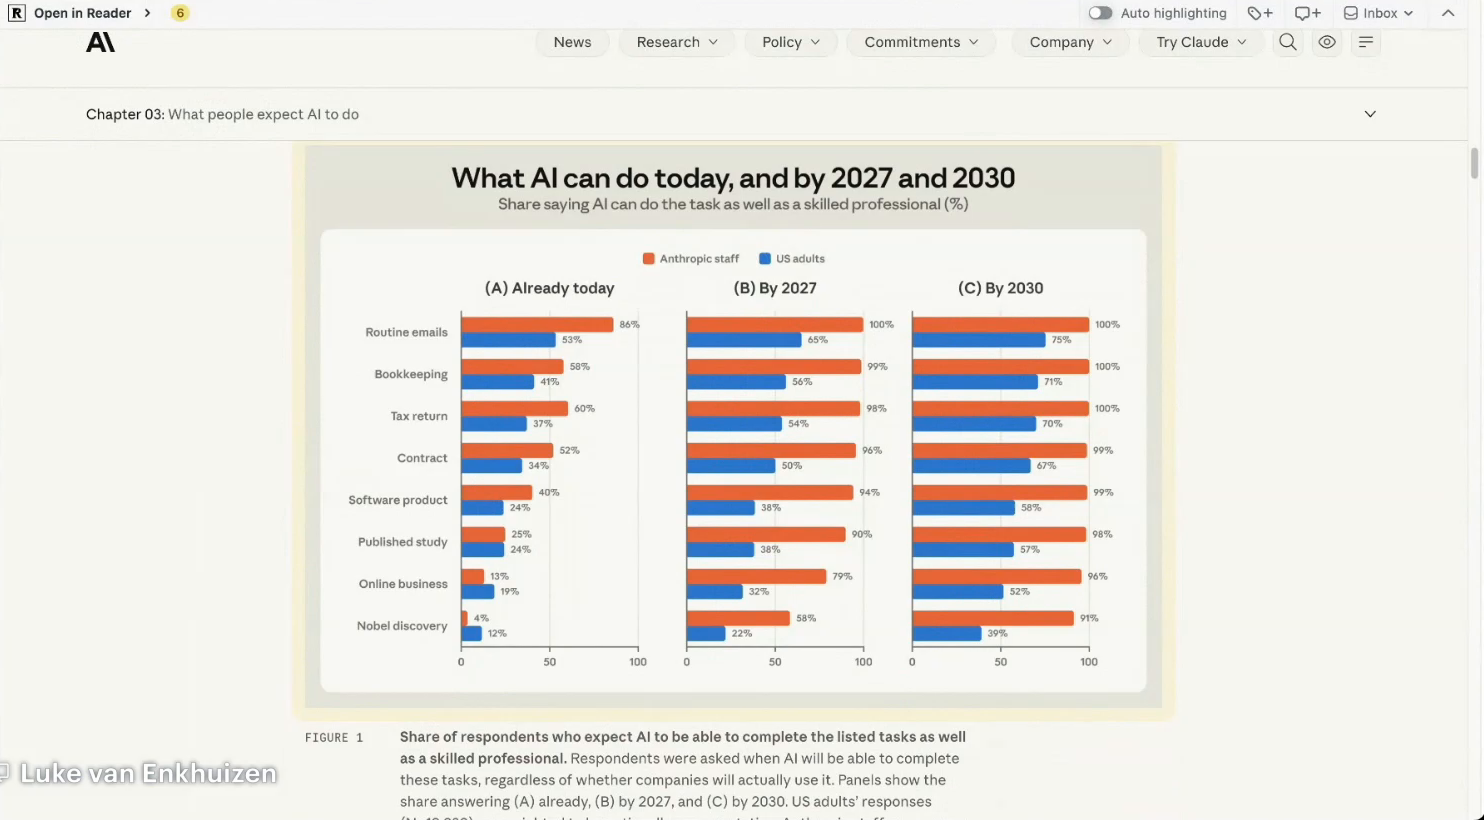
Anthropic heeft gemeten wat AI vandaag al kan, en wat mensen denken dat het kan.
Routine-e-mails: ongeveer 86% kan vandaag met AI worden afgehandeld. De meeste volwassenen gokken op 50%. Boekhouding en bonnetjes: 60%, tegen een verwachting van 40%.
Hun verwachting: eind volgend jaar werkt AI op dit soort taken op het niveau van een ervaren professional. In 2030 in alle domeinen.
Anthropic heeft er belang bij om dat te zeggen. Maar de trend in de modellen wijst dezelfde kant op.
Dit is niet om je bang te maken. Dit is juist een gigantische kans.
Alle software waar je aan vastzat en die niet meewerkte, kun je je nu eigen maken. Je moet de skills opbouwen, zeker. Maar je hebt intelligentie op schaal om je daarbij te helpen.
Robotisering, al jaren een droom van veel bedrijven, komt dichterbij omdat besturingen binnen bereik komen. En we hebben het hard nodig. Er zijn gewoon niet genoeg mensen.
Eerder dit jaar schreef ik al dat de agents er zijn en de maakindustrie pas aan het begin staat. Dat stuk is sindsdien alleen maar actueler geworden.
De val waar de meeste bedrijven nu in stappen
Hier wordt het praktisch, want hier zie ik het misgaan.
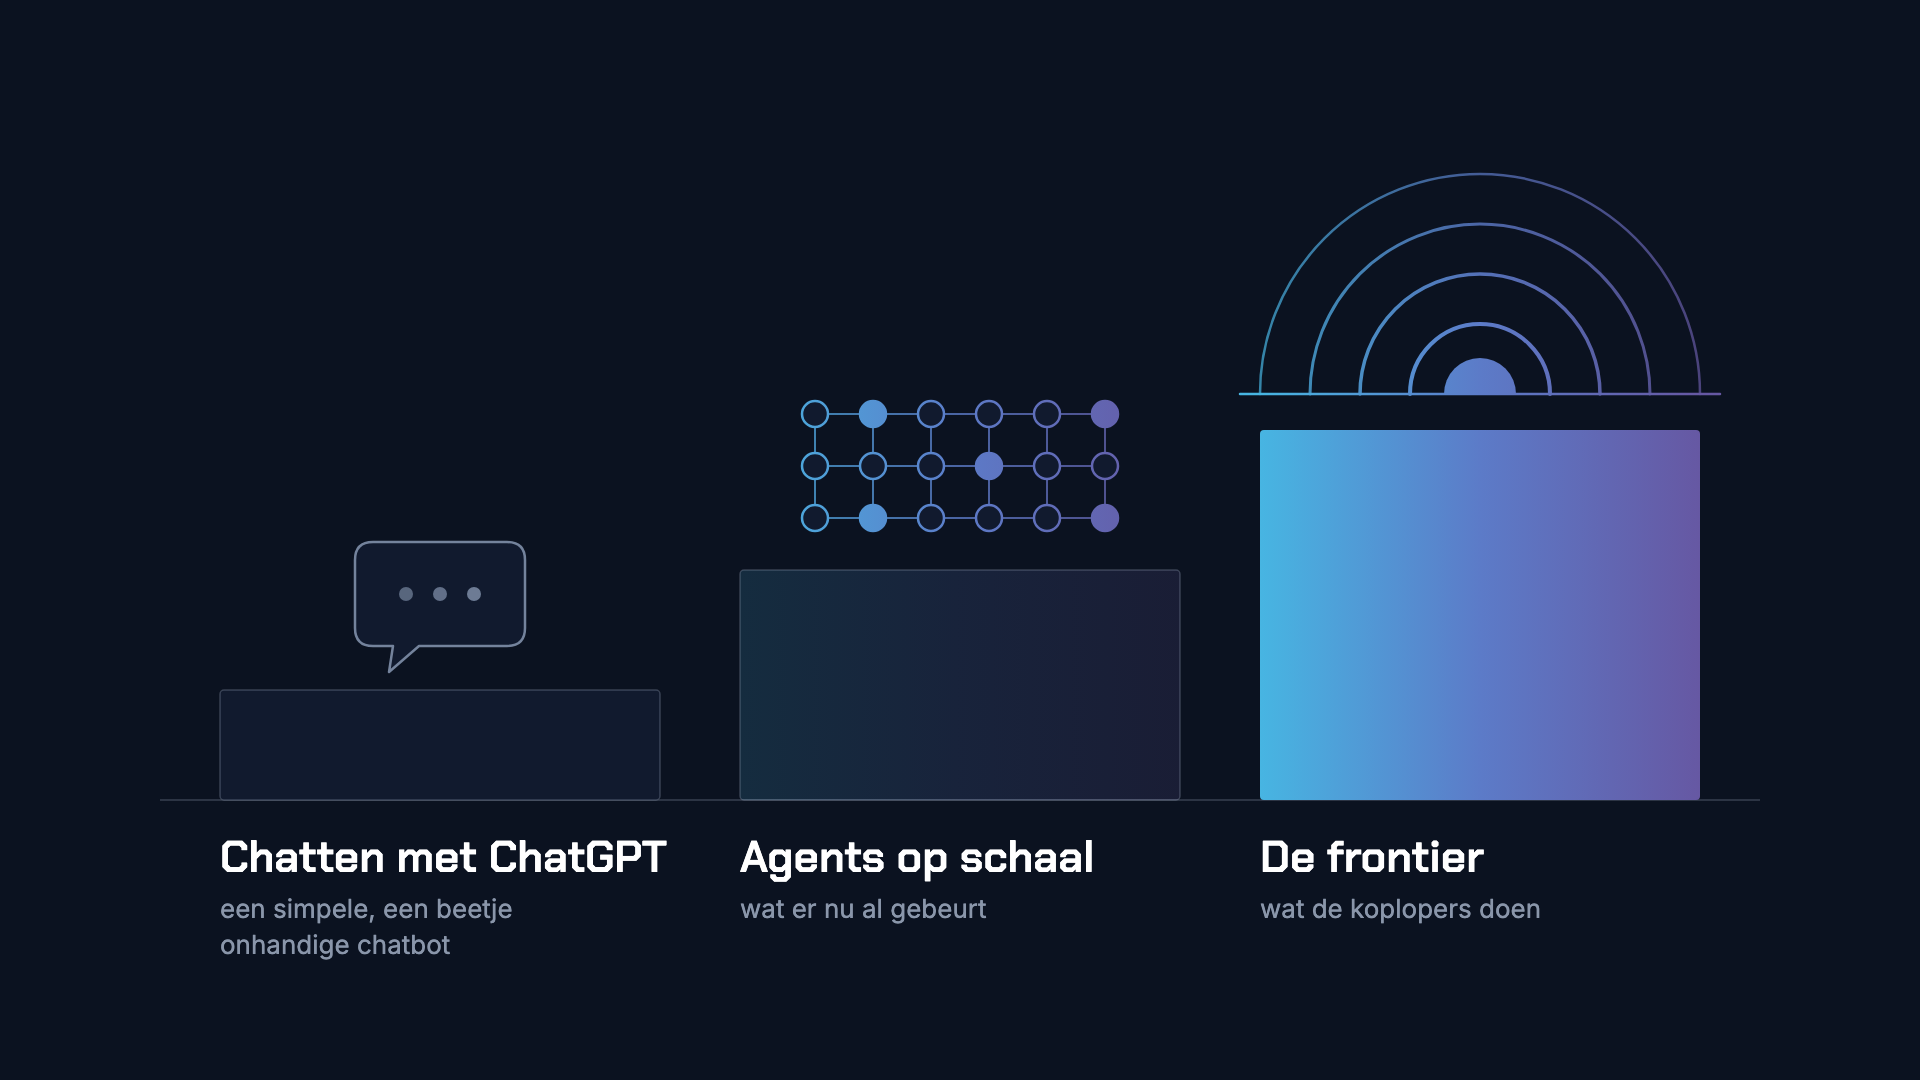
De meesten van ons hebben wel eens met ChatGPT gechat, vaak de gratis versie. Je logt in, je probeert wat, er komt informatie uit. Een simpele, een beetje onhandige chatbot.
Weinig mensen hebben gezien wat agents op schaal doen. Tientallen instanties van een model naast elkaar, die samenwerken en coördineren. Alsof je een heel team opstelt. Dat gebeurt nu al, met gemengde resultaten.
Maar bijna niemand ziet nog in wat er gaat gebeuren als we gaan werken met echte swarms die dus coördineren met duizenden agents en daarmee volledige bedrijfsvoeringen overnemen.
Ondertussen wordt AI overal op je neergegooid. Het zit ineens in je e-mail. Je ERP-leverancier komt ermee.
Agents worden pas nuttig zodra de context van je hele bedrijf beschikbaar is. De harness, de app en de bestanden op je computer komen daarna.
Stel dat een agent de mail van een klant leest. Hij beoordeelt wat de klant vraagt, haalt de leverdatum erbij, kijkt wat er gebeurd is en of het om een kwaliteitsvraag gaat. Dan moet die agent weten wat er allemaal speelt en draait.
Dat is context.
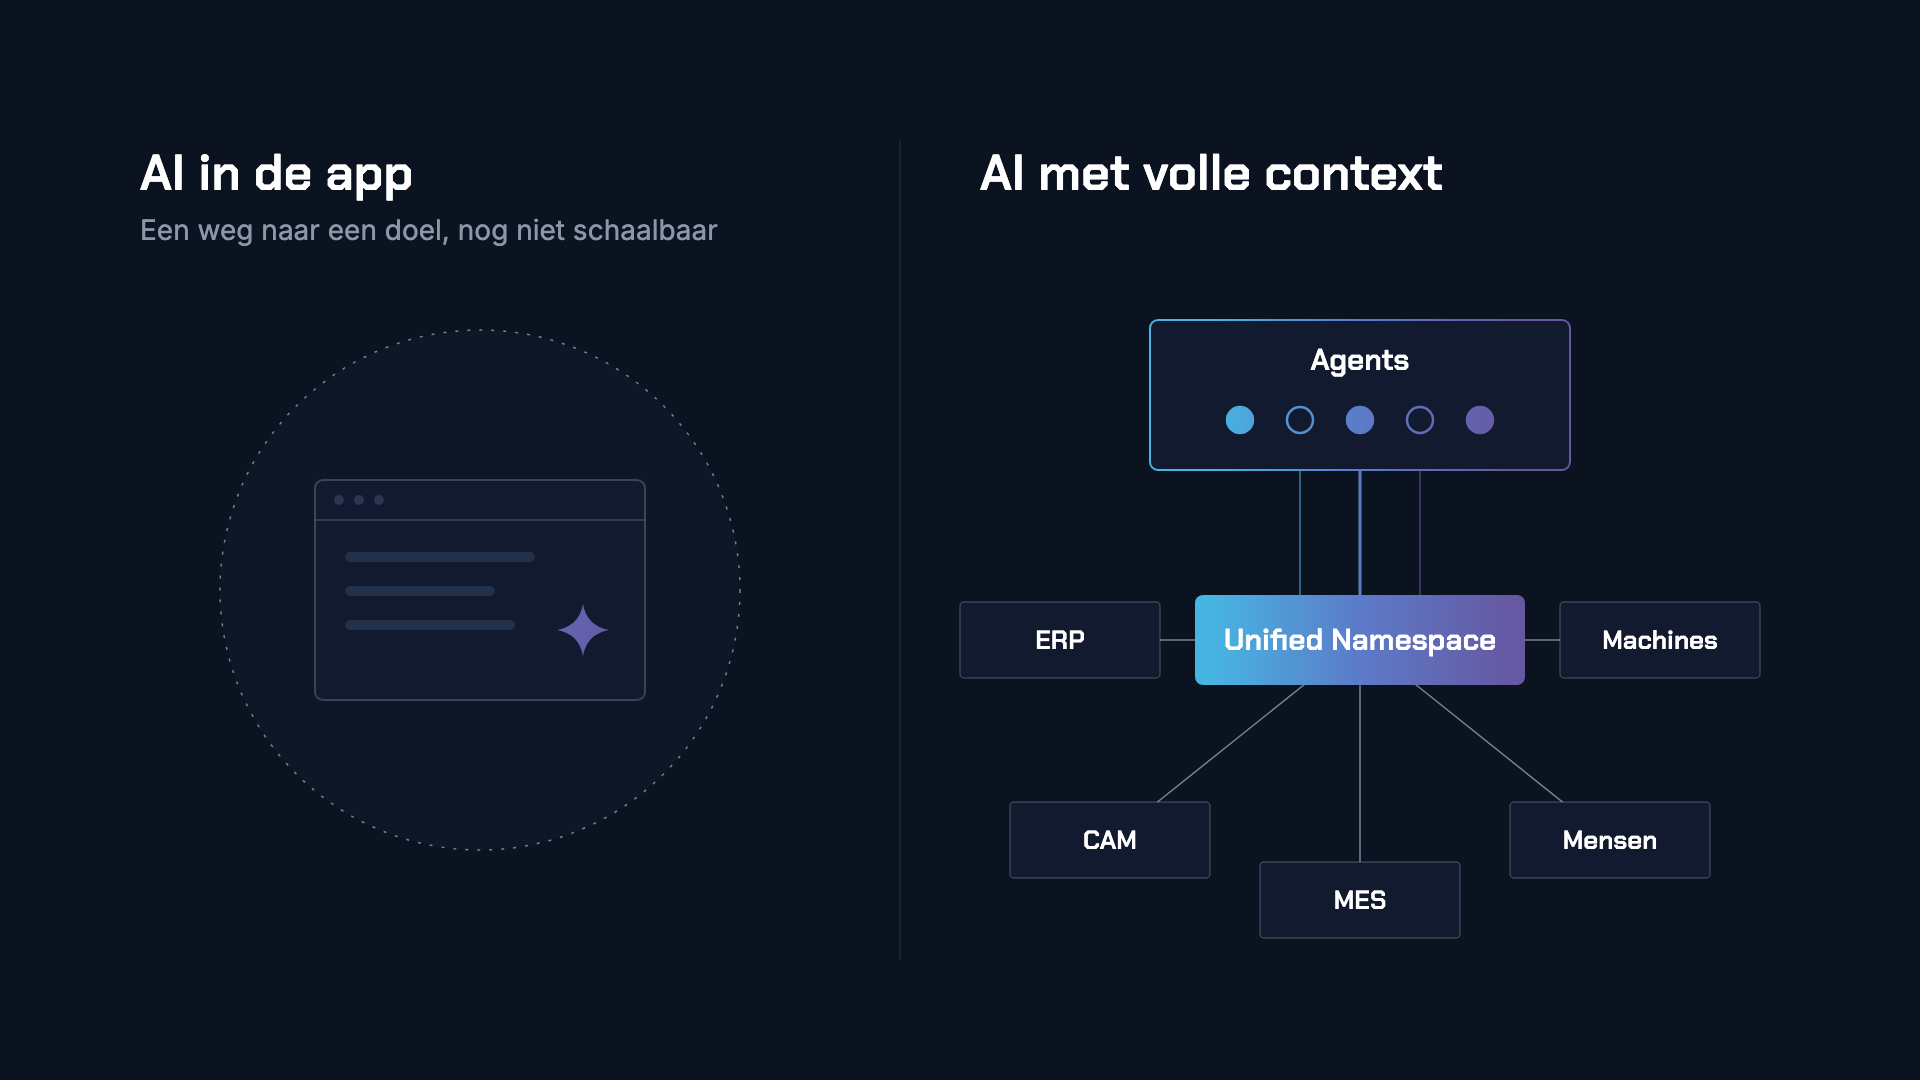
En die context komt niet uit je ERP. ERP is bedoeld voor één doel: je verkoop, je orders en eventueel je bonnen bijhouden. Nooit voor al die andere dingen.
Een eigen app lost het ook niet op. Hoe krijg je daar machinedata in? En hoe ziet iemand realtime waar een order in de fabriek staat?
Daar heb je een Unified Namespace voor nodig: de hub die data beschikbaar maakt voor agents. Wat ik de laatste jaren steeds weer bevestigd krijg, is dat je eerst context nodig hebt.
Weet je nog, die metaalbedrijven die nog middenin Industrie 4.0 zitten? Dat huiswerk is nu de toegangskaart. Het kan ook via MCP, een protocol waarmee een model bij je systemen kan. Maar als de intelligentie-explosie echt doorbreekt, wil je dat je bedrijf er het maximale uit haalt. Dan moet je hub op orde zijn.
De wereld waarin een leverancier software maakt en consultants stuurt, verdwijnt in rap tempo. Wim zegt het op YouTube zo: ERP is doomed. Dat beaam ik, en ik schreef er eerder een lang stuk over. De pakketten zoals we ze kennen zijn achterhaald, en alle code en intelligentie om het zelf te maken staat al op het internet.
We gaan naar een wereld waarin software op jouw maat wordt gemaakt, en je alleen nog gespecialiseerde systemen nodig hebt.
Hierover schreef ik eerder:
Hoe ik nu naar mijn eigen werk kijk
Want dat is veranderd. Ik zie drie lagen.
- De Unified Namespace, de datahub. Machines en systemen online, data verzamelen, contextualiseren en opslaan. Continu, in een loop.
- De knowledge graph. Data analyseren, visualiseren en aan elkaar koppelen, zodat de informatie in je bedrijf zo georganiseerd is dat agents ermee kunnen werken.
- Agents die daarop acties ondernemen. En wat nu ook binnen bereik komt: machine learning, de toekomst voorspellen op je eigen data. Ook die modellen zijn open source.
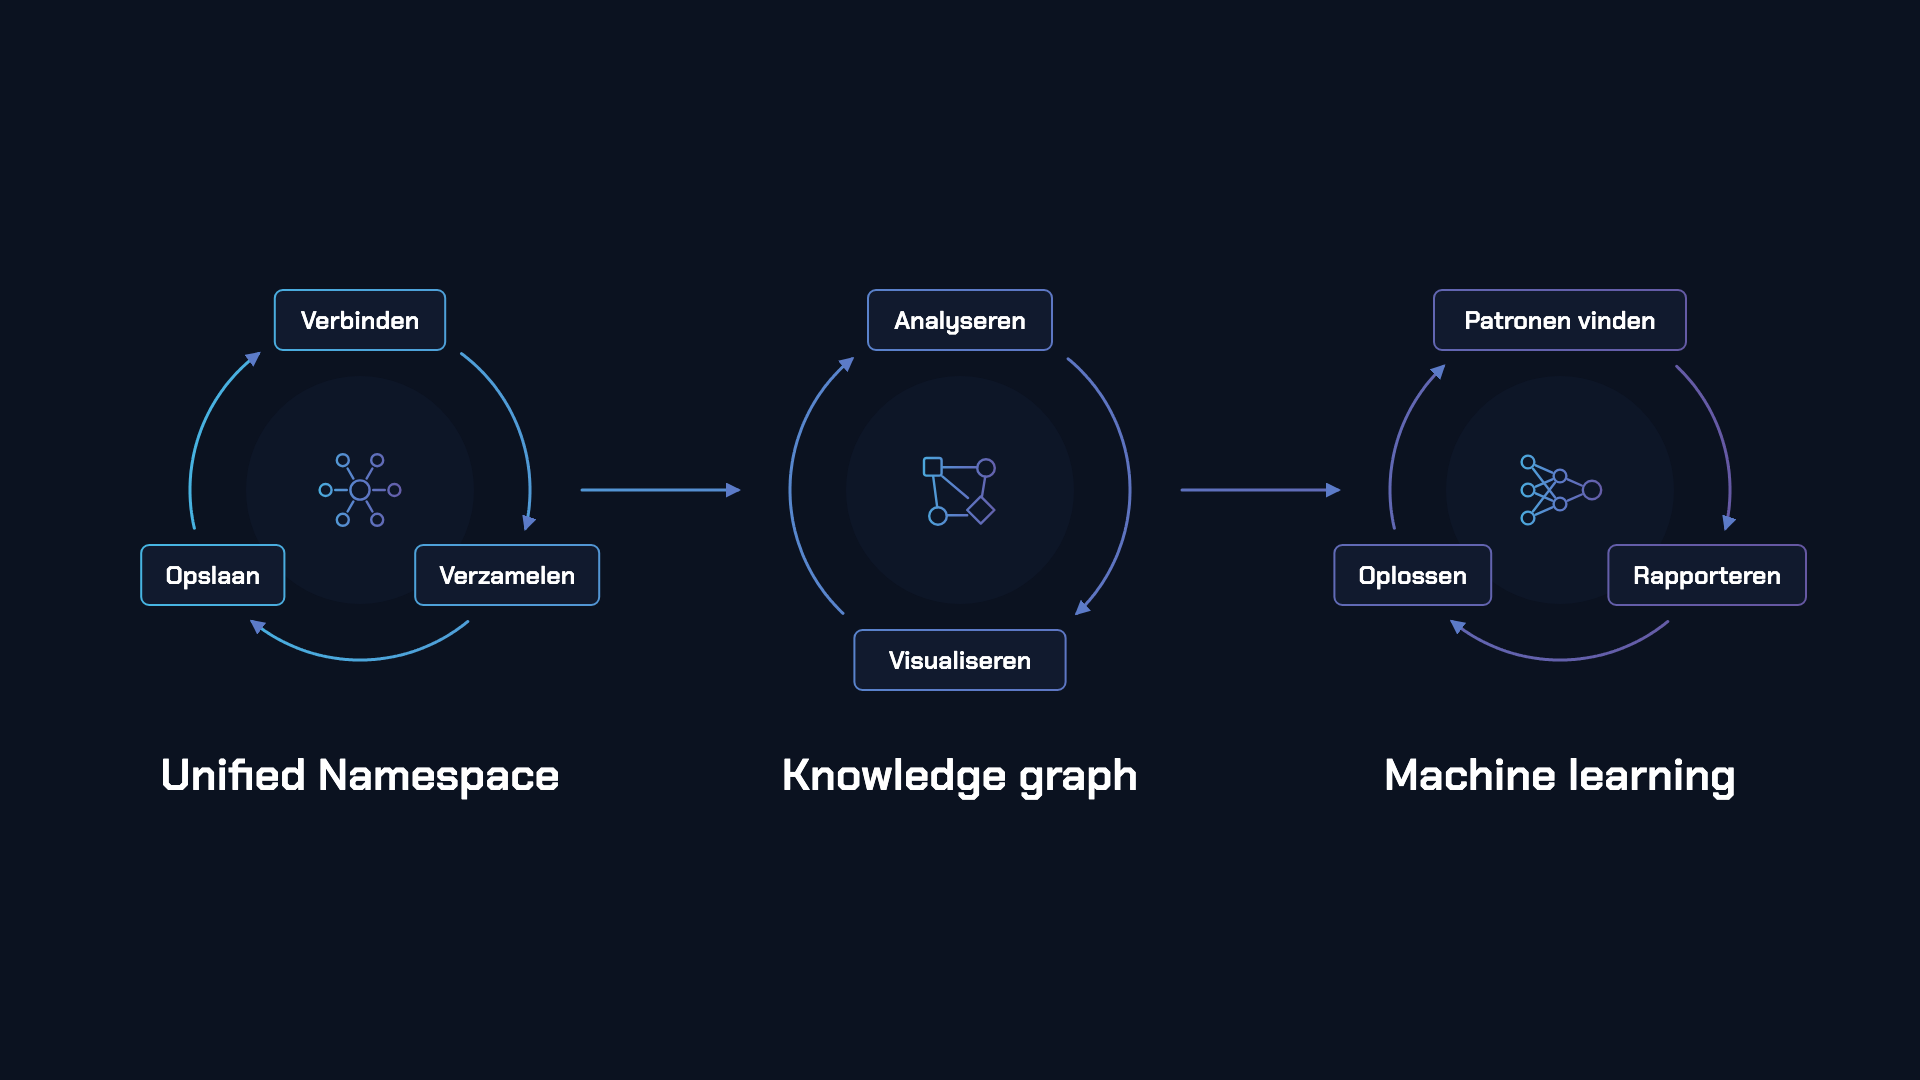
Daaronder liggen acht handelingen die je hoe dan ook moet kunnen. Links het huiswerk van Industrie 4.0: verbinden, verzamelen, opslaan, analyseren. Rechts wat je nu op schaal kunt doen met AI: visualiseren, patronen vinden, rapporteren, oplossen.
Om daar te komen moet je huiswerk doen. Leren. Problemen oplossen. Dingen zichtbaar maken. En dat herhalen. Zo verbeter je je Namespace, je data en je kennis. En je wordt vanzelf handig in programmeren.
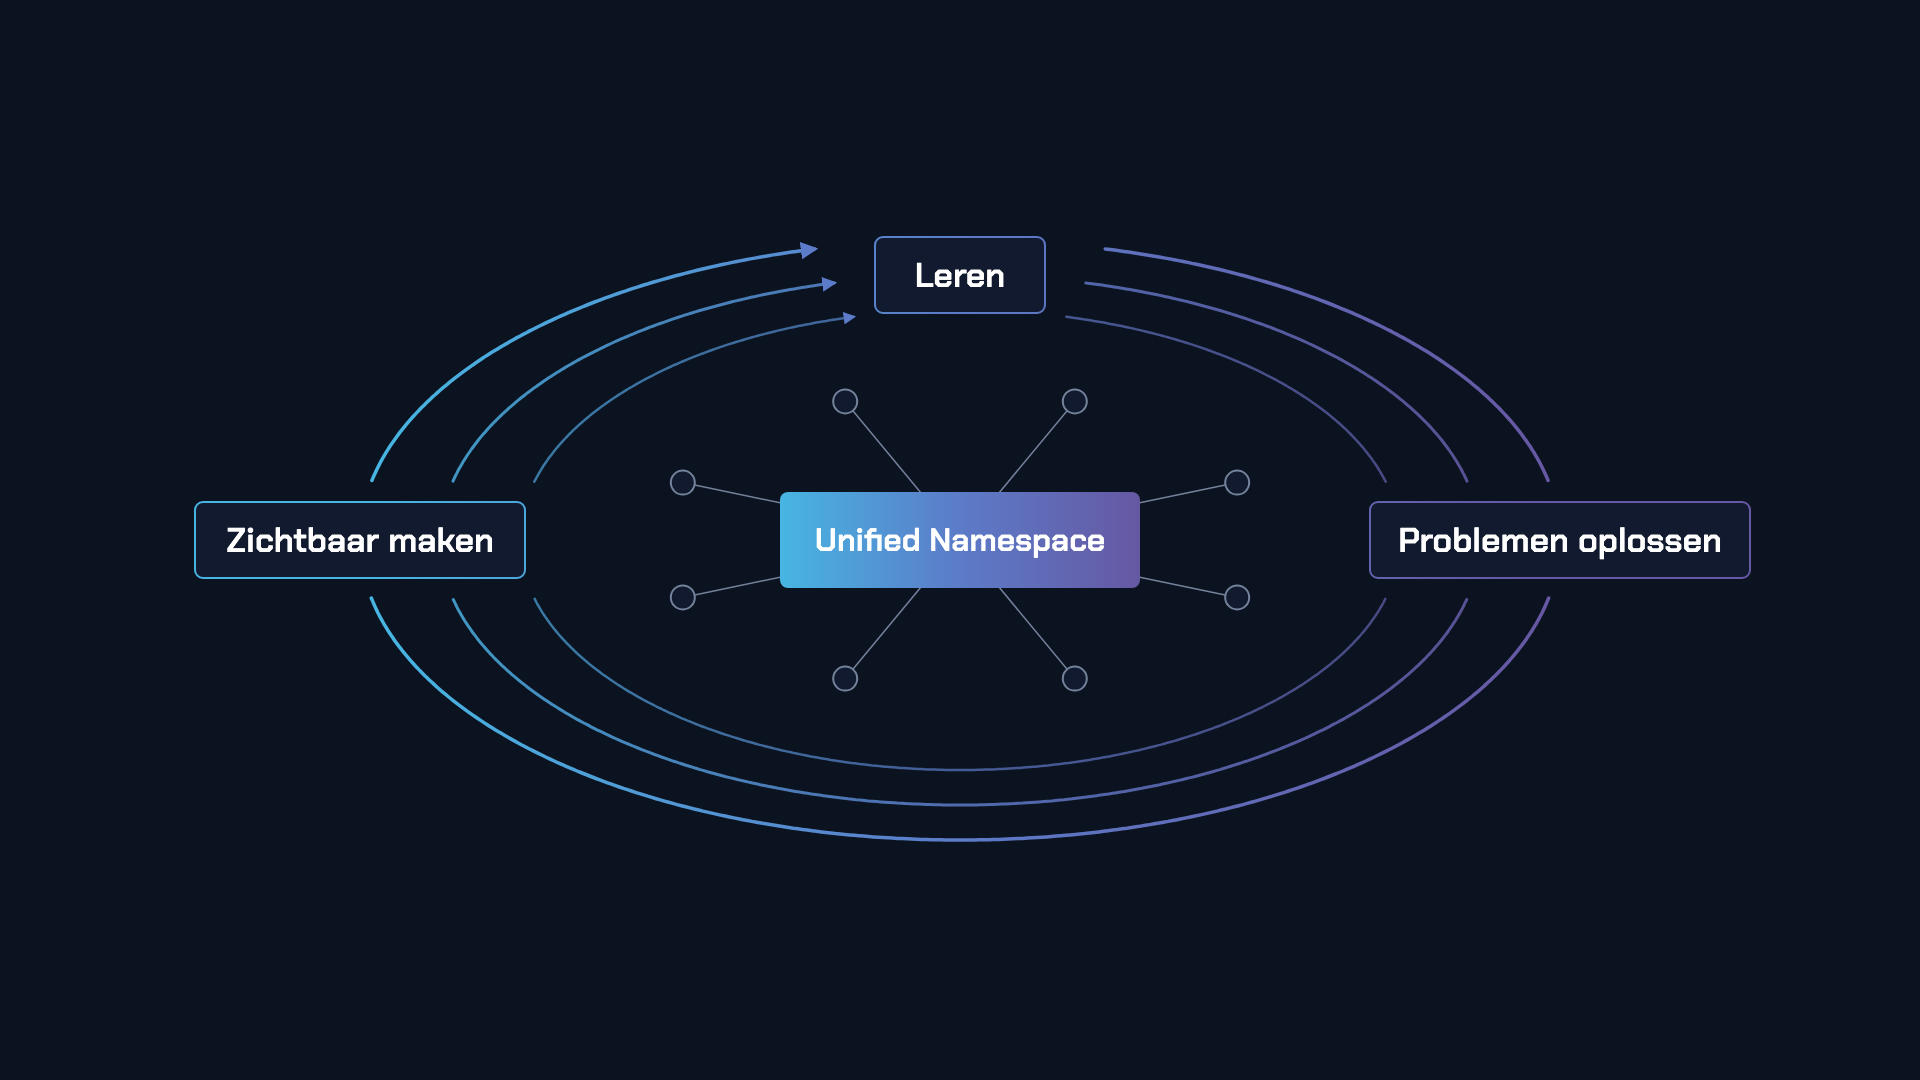
Het punt is: de intelligentie is er al, en ze verdubbelt om de paar maanden. Wat in de meeste metaalbedrijven ontbreekt, is de context waar die intelligentie op kan werken. Tien keer zo veel context. Daar komt die tien keer vandaan.
Wat je morgen kunt doen
Dit artikel was bewust theoretisch. Wil je weten wat dit voor jou betekent, dan moet je eerst de trends kennen.
Mijn enige actie voor jou: onderneem het beste AI-model en betaal voor je AI-provider.
Anthropic en OpenAI zijn op dit moment de wereldleiders. Mistral is het enige Europese model op schaal, maar het loopt achter voor agentisch werk. Achter je eigen systemen zeker bruikbaar, en de tekstverwerking is extreem goed. De Chinese modellen zijn al goed. Doe er ervaring mee op. En daarna: stel je software beschikbaar, en pak daarop door.
Boulton verkocht kracht. Ford verkocht tijd. Morley verkocht flexibiliteit. Wat er nu te koop is, is intelligentie. De vraag is alleen of jouw bedrijf er iets mee kan.
Welk thema is voor jou nu het actueelst? Laat het weten in de reacties, via de podcast of per mail. Vlak voor de stream kwam al een vraag binnen over hoe je omgaat met je eigen agent. Daar gaat de volgende aflevering over.
De hele aflevering terugkijken? Hier staat hij, met de podcastversie eronder voor onderweg.
Verder lezen
- AI is underhyped (ook al voelt het als hype), het stuk waar dit verhaal op doorbouwt.
- De agents zijn er. En de maakindustrie staat pas aan het begin, wat een agent mist: je wereld.
- Het begin, het succes en het einde van ERP in de metaal, vijf generaties software.
- Unified Namespace: weg met spaghetti-integraties, de verbindende laag
- AI in de fabriek: drie niveaus in de productie, waar je kunt beginnen.
- Het verschil tussen weten en doen, waarom kleine bedrijven nu zelf bouwen.